먼저 결과표를 만드세요: 원본 A2와 결과 셀은 분리합니다
A2에 SEOUL-0042를 입력하고 B2 등 다른 셀에 수식을 넣습니다. 아래 결과는 원본이 문자 데이터이고 앞뒤에 공백이 없다는 전제입니다. 따옴표는 결과가 문자열이라는 설명용 표시이며 셀에 따옴표까지 보인다는 뜻은 아닙니다.
앞 다섯 글자: =LEFT(A2, 5) → 문자열 "SEOUL". 뒤 네 글자: =RIGHT(A2, 4) → 문자열 "0042"입니다. 추출한 결과를 비교할 때 방향과 개수를 별도로 확인하세요.
일곱 번째부터 두 글자: =MID(A2, 7, 2) → 문자열 "00". 전체 문자 수: =LEN(A2) → 숫자 10입니다. 추출 결과가 숫자처럼 보이는 경우와 문자 수가 실제 숫자인 경우를 같은 것으로 읽지 않습니다.
LEFT: 앞에서 몇 글자를 가져올지 먼저 정합니다
=LEFT(A2, 5)는 맨 앞에서 다섯 글자를 가져옵니다. SEOUL-0042의 여섯 번째 글자는 하이픈이므로 개수를 6으로 바꾸면 SEOUL-까지 나옵니다. 두 번째 인수는 끝 위치를 검색하는 값이 아니라 가져올 문자 수입니다.
Excel의 LEFT(text, [num_chars])에서 대괄호는 선택 인수라는 문서 표기입니다. 실제 수식에 대괄호를 입력하지 않습니다. =LEFT(A2)는 한 글자 S를 반환합니다. 앞 다섯 글자를 원하는데 개수를 생략하면 함수는 동작해도 요구한 결과는 아닙니다.
RIGHT: 끝에서 가져와도 문자 순서는 뒤집지 않습니다
=RIGHT(A2, 4)는 뒤의 네 글자 0042를 그대로 가져옵니다. 오른쪽부터 읽는다고 2400으로 뒤집지 않습니다. 끝 두 글자를 원한다면 문자 수를 2로 지정합니다. 마지막 위치 번호를 두 번째 인수로 넣는 함수가 아닙니다.
=RIGHT(A2)는 마지막 한 글자 2를 반환합니다. 앞과 뒤의 추출은 모두 문자 수 생략이 가능하지만 결과 위치가 다릅니다. 코드 끝부분이 항상 네 글자라는 조건일 때만 고정 숫자 4를 사용하고, 길이가 달라지는 자료에는 다른 길이 계산이 필요합니다.
MID: 시작 위치 7과 추출 개수 2를 분리하세요
SEOUL-0042를 왼쪽부터 세면 S=1, E=2, O=3, U=4, L=5, 하이픈=6, 0=7, 0=8, 4=9, 2=10입니다. =MID(A2, 7, 2)는 일곱 번째부터 두 글자인 00을 가져옵니다. 세 번째 인수 2는 두 번째 위치까지라는 뜻이 아닙니다.
Excel의 MID(text, start_num, num_chars)는 세 인수가 모두 필요합니다. 끝까지 가져오고 싶어도 추출 개수를 빼지 않습니다. =MID(A2, 7, LEN(A2))처럼 충분한 개수를 지정하면 남은 0042만 반환합니다. Access의 선택 길이 문법을 옮겨 쓰지 마세요.
빈 문자열과 오류: 0, 범위 초과, 잘못된 시작점을 나눕니다
LEFT·RIGHT의 문자 수를 0으로 지정하면 빈 문자열 ""이며 원문보다 많은 개수를 지정하면 원문 전체입니다. =LEFT(A2, 20)과 =RIGHT(A2, 20)는 SEOUL-0042입니다. 부족한 글자를 공백으로 채워 새 길이를 만드는 함수가 아닙니다.
=MID(A2, 9, 20)은 남은 42만 반환합니다. 시작 위치가 원문 밖인 =MID(A2, 11, 2)는 빈 문자열입니다. 반면 =MID(A2, 0, 2)와 음수 개수를 지정한 =MID(A2, 1, -1)은 #VALUE! 오류입니다. 범위가 길다는 이유만으로 모든 식이 오류가 되는 것은 아닙니다.
빈 문자열은 정상 계산 결과일 수 있고 오류 값은 잘못된 조건을 알립니다. 결과가 안 보인다는 이유로 두 상황을 묶지 말고 수식 입력줄에서 시작 위치와 개수를 확인하세요.
LEN: 보이는 글자뿐 아니라 공백과 하이픈도 셉니다
=LEN(A2)는 숫자 10입니다. A3에 앞뒤 일반 공백이 하나씩 있는 " SEOUL-0042 "를 넣으면 =LEN(A3)은 12입니다. 셀 화면에서 공백이 잘 보이지 않아도 값 안에 있으면 길이에 포함됩니다.
실제로 빈 A6 셀의 =LEN(A6)은 0입니다. 이것과 공백만 입력한 셀을 같은 것으로 보지 않습니다. LEFT·RIGHT·MID의 추출 위치도 원문 공백을 포함해 세므로 길이 문제와 추출 문제는 원본 데이터를 같은 기준으로 읽어야 합니다.
이 글의 예제는 일반 영문·숫자·하이픈·공백 문자열입니다. 모든 이모지가 화면에서 보이는 모양 하나당 길이 1이라는 규칙으로 확대하지 않습니다. 특수 유니코드 문자열은 Excel 호환성 버전 등에 따라 문자 계산을 따로 확인해야 합니다.
앞자리 0: 문자 0042와 숫자 42의 표시 형식은 다릅니다
=RIGHT(A2, 4)의 결과는 문자 0042입니다. 코드 앞의 0이 남아 있는 상태에서 숫자로 변환하면 42가 되어 자릿수 표현이 달라집니다. 계산해야 하는 수량인지 구분해야 하는 코드인지 먼저 결정하세요.
A4의 실제 값이 숫자 42이고 표시 형식만 0000이라서 화면에 0042가 보인다고 가정합니다. 이때 =LEN(A4)는 2, =RIGHT(A4, 4)는 문자 42입니다. 수식이 화면에 표시된 0042를 그대로 잘라 읽는다고 생각하면 틀립니다.
반대로 A5를 텍스트 형식으로 준비한 뒤 문자 0042를 입력했다면 =LEN(A5)는 4입니다. 이미 사라진 앞자리 0의 원래 개수를 표시 형식 변경만으로 알아내는 것은 아닙니다. 이 예제는 요구 자릿수가 알려진 경우와 원본 코드가 보존된 경우를 구분하기 위한 것입니다.
고정 길이와 구분자: 코드 길이가 달라지면 숫자를 바꿔야 합니다
SEOUL-0042처럼 앞부분이 다섯 글자라고 정해져 있을 때는 LEFT(A2, 5)가 맞습니다. BUSAN-0042와 SUWON-0042도 같은 길이일 수 있지만 지역 이름이나 앞코드가 늘어나면 하이픈 위치가 달라집니다. 자료 형식이 고정인지부터 판단하세요.
첫 하이픈 앞을 가져오는 식은 =LEFT(A2, SEARCH("-", A2) - 1)입니다. SEARCH가 반환한 위치 6에서 하이픈 한 글자를 제외해 앞의 다섯 글자를 가져옵니다. SEARCH 결과는 글자가 아니라 위치입니다.
이 결합 식은 원문에 첫 하이픈이 있다는 전제입니다. 여러 하이픈이 있는 자료에서 마지막 하이픈 뒤를 원한다면 같은 기본 식을 그대로 쓰지 않습니다. 구분자를 찾는 함수 전체의 비교는 이 글의 범위가 아닙니다.
LEN 결합: 구분자 뒤 문자 수를 원문 길이에서 계산합니다
첫 하이픈 뒤를 가져오는 =RIGHT(A2, LEN(A2) - SEARCH("-", A2))는 전체 10글자에서 하이픈까지 6글자를 빼 네 글자를 추출합니다. 결과는 문자 0042입니다. 여기에 LEN이 필요한 이유는 마지막 네 글자라는 고정 조건이 없기 때문입니다.
=MID(A2, SEARCH("-", A2) + 1, LEN(A2))도 첫 하이픈 다음부터 끝까지 가져옵니다. 시작은 6+1이고 추출 개수는 남은 길이보다 충분히 큰 10입니다. MID가 원문 끝에서 멈추므로 결과에 공백을 더하지 않습니다.
하이픈이 없는 SEOUL0042에서 SEARCH("-", 원본)은 #VALUE!입니다. 문자가 없을 때 0이 나온다고 전제하면 안 됩니다. 중첩 식이 틀렸다면 먼저 SEARCH 부분만 계산해 구분자 유무를 확인하고, 누락 자료를 어떻게 처리할지는 문제의 요구사항으로 결정하세요.
셀 주소와 문자 상수: 따옴표가 원본을 바꿉니다
=LEFT(A2, 5)는 A2에 들어 있는 값을 읽습니다. =LEFT("A2", 5)는 문자 A2 자체를 읽어 A2를 반환합니다. 셀 주소를 큰따옴표로 감싸면 같은 값이 참조되는 것이 아닙니다. 문자열을 직접 쓸 때만 =LEFT("SEOUL-0042", 5)처럼 따옴표를 사용합니다.
결과 셀을 원본 A2와 나눠 두세요. A2에 A2를 읽는 추출 수식을 덮어쓰면 원본이 사라지고 순환 참조도 생깁니다. 원본 열, 추출 결과 열, 길이 확인 열을 나누면 수식이 잘못되었는지 원본이 달라졌는지 확인하기 쉽습니다.
수식 복사: 행마다 원본이 바뀌어야 하는지 확인하세요
B2의 =LEFT(A2, 5)를 B3으로 아래 복사하면 참조가 A3으로 바뀝니다. 각 행의 코드를 읽으려는 목적이라면 이 상대 참조가 맞습니다. 모두 같은 결과가 나온다고 함수만 바꾸지 말고 원본 셀을 먼저 확인하세요.
=$A$2처럼 열과 행을 모두 고정하면 아래 복사해도 A2를 계속 읽습니다. A열은 유지하고 행만 바꾸려면 =LEFT($A2, 5)처럼 열만 고정할 수 있습니다. 아래 복사하면 $A3을 읽습니다. 달러 기호는 함수 결과를 고정하는 것이 아니라 셀 주소의 이동을 제어합니다.
첫 행에서 결과를 확인한 다음 한 행만 복사해 수식 입력줄을 비교하세요. 추출 방향, 개수, 원본 셀 가운데 어느 부분이 잘못되었는지 나누면 문제를 빨리 찾을 수 있습니다. 전체 실기 작업 순서는 관련 가이드에서 이어집니다.
문자 연결: &는 합계가 아니라 새 문자열을 만듭니다
=LEFT(A2, 5) & "/" & RIGHT(A2, 4)의 결과는 SEOUL/0042입니다. 앞부분, 문자 상수 슬래시, 뒷부분을 순서대로 연결합니다. 연결 기호 &를 숫자 더하기 기호 +와 같은 것으로 바꾸지 않습니다.
함수 인수를 구분하는 쉼표, 원문 안의 하이픈, 문자열을 연결하는 &는 역할이 다릅니다. 새 코드가 완성되어도 추출식이 원본 셀의 값을 자동으로 수정하는 것은 아닙니다. 출력 셀의 결과와 입력 열의 원본을 따로 봅니다.
셀프 체크 7문제: 답보다 먼저 셀 값과 인수를 읽으세요
다음은 자체 복습 문항입니다. 1~4번의 원본 A2는 SEOUL-0042입니다. 수식을 함수 선택, 시작 위치, 개수, 반환 종류로 나누고 답을 보지 않은 상태에서 결과를 적어 보세요.
1. =LEFT(A2)의 결과는 무엇인가요? 정답: 문자 S입니다. Excel에서 문자 수를 생략하면 1입니다.
2. =RIGHT(A2, 4)의 결과는 숫자 42인가요? 정답: 문자 0042입니다. 추출 결과의 앞자리 0을 없애지 않습니다.
3. =MID(A2, 7, 2)의 결과는 무엇인가요? 정답: 문자 00입니다. 시작 위치 7과 추출 개수 2를 구분합니다.
4. =MID(A2, 11, 2)는 #VALUE!인가요? 정답: 아닙니다. 시작 위치가 원문 밖이므로 빈 문자열입니다. 위치 0을 지정한 오류와 다릅니다.
5. 앞뒤에 일반 공백 하나씩 있는 " SEOUL-0042 "의 LEN은 얼마인가요? 정답: 12입니다. 하이픈과 공백을 모두 셉니다.
6. 실제 숫자 42에 표시 형식 0000을 적용한 셀의 LEN은 4인가요? 정답: 2입니다. 화면 표시와 저장 값을 구분합니다.
7. B2의 =LEFT($A2, 5)를 B3으로 복사하면 어떤 셀을 읽나요? 정답: A3입니다. A열은 고정하고 행은 이동합니다.
시험 직전 요약과 검증 범위
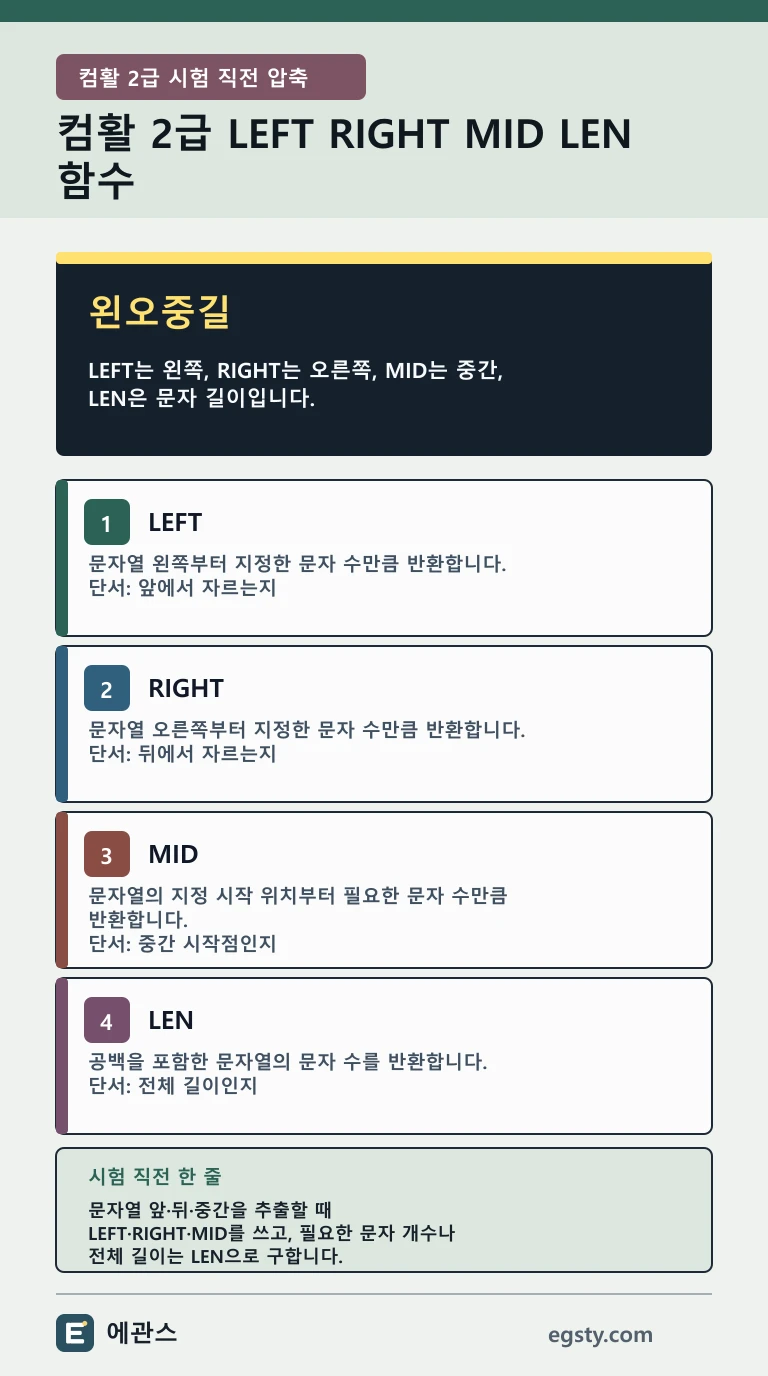
다섯 줄로 마무리하세요. 앞은 LEFT, 뒤는 RIGHT, 위치부터는 MID, 문자 수는 LEN입니다. LEFT·RIGHT의 개수 생략은 1, MID의 시작과 개수는 필수입니다. 위치는 1부터 셉니다. 공백·앞자리 0·저장 값을 확인합니다. 마지막으로 복사된 수식의 셀 주소를 비교합니다.
Microsoft Support의 LEFT·RIGHT·MID·LEN·SEARCH, 셀 참조, 계산 연산자, 앞자리 0 보존, 수식 개요 문서를 대조했습니다. 실제 Excel 워크시트에서 일반 문자열·공백·표시 형식·오류 값의 수식 26개와 아래 복사 2건을 확인했습니다. 공식 시험 환경이나 실제 기출을 검증한 것은 아닙니다.
이제 컴활 2급 스프레드시트 함수 단원에서 방향과 길이 구분부터 복습하세요. 손으로 확인할 때는 원본 코드 하나, 앞뒤 공백이 있는 코드 하나, 숫자와 문자로 저장한 코드 하나를 비교해 틀린 조건만 남기면 됩니다. 함수 전체 공부 흐름은 관련 기본 함수 가이드로 이어가세요.